

从任务失败中获取新控制器,卡内基梅隆团队用 ELEVATE 帮机器狗补能力
作者:江思奇
搭载机械臂的四足机器人,比轮式机器人更能适应复杂环境。但却有一个硬限制:所有动作都要提前训练好,存进动作库里。 如果库里没有对应的动作,哪怕换再多任务代码,机器人也做不出这个姿态。
那么机器人可不可以自己发现,任务失败是因为缺少哪个动作,然后自动学会这个新动作?
针对这个问题,卡内基梅隆大学与三菱电机研究实验室(MERL)团队于 10 月 28 日 发表论文《ELEVATE: Agentic Controller Acquisition from Task Failure for Quadrupedal Manipulation》(ELEVATE:从任务失败中获得代理控制器以实现四足操作),提出 ELEVATE 智能体框架。当任务程序反复失败时,系统会判断机器人缺少哪种全身动作能力,再设计强化学习训练,让机器人学会这些动作。
论文的第一作者是 Shiqi Liu。作者中还有卡内基梅隆大学机械工程系副教授 Ding Zhao,他也是 Safe AI Lab 负责人,其研究方向涉及机器人与强化学习。
团队提出 ELEVATE 框架就是让智能体自主完成判断。
它会不断改写任务代码反复尝试。当多种写法全都卡在同一个物理限制上时,它就明白:不是代码的问题,是缺少对应的全身控制动作。接着它自动设定要学的动作、设计训练规则,用强化学习训练出新控制器,测试没问题就放进动作库,再重新尝试任务。
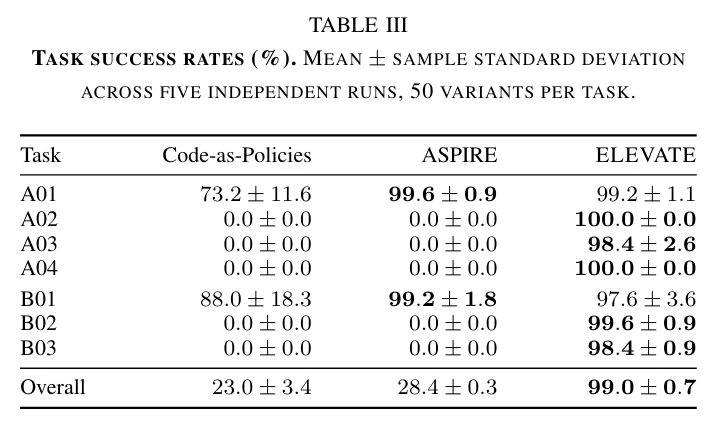
在七项仿真测试任务里,ELEVATE 五次独立运行的平均成功率 99.0%;对照组只能调用固定动作库,两组基线成功率仅 28.4%、23.0%。
研究人员还把训练好的控制器直接放到宇树 Go2 搭配 PiPER 机械臂的真机上,不做额外调试。货架取物 20 次成功 18 次,地面往货架放物品 20 次成功 16 次。
这套方案能不能持续落地,要看两点:
- 智能体能不能稳定分清「代码写错」和「机器人做不出这个动作」
- 新学出来的控制器,能不能不局限在预设的模板里
从失败定位能力缺口
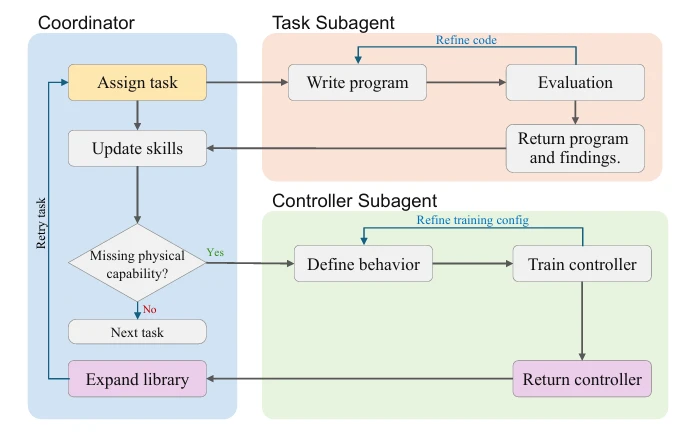
ELEVATE 将整套流程分给三类智能体配合完成。
协调者统筹调度、维护能力库、执行留出测试;
任务子智能体聚焦单一任务编写程序,在 15 种开发变体中反复尝试,结合数值结果、执行轨迹、画面反馈迭代修改;
控制器子智能体专门设计、训练全新控制器。
每接收一项任务、每训练一个控制器,系统都会生成上下文相互独立的全新子智能体,它们仅依靠文件交换信息、记录发现,不会共享完整对话历史。
技能本质是可反复调用的函数:上层任务程序把多个技能串联成执行流程;底层控制器则把感知观测转化为 18 个关节的运动指令,其中 12 个关节属于腿部,另外 6 个属于机械臂。

ELEVATE 对「判定缺少能力」设置了保守严格的标准。
必须同时满足四条条件:大部分开发变体都卡在物理层面失败、执行流程本身没有逻辑错误、多种完全不同的实现方案都存在显著误差、现有能力库里找不到可行的补救手段,协调者才会启动新控制器的训练流程。
只有多种合理方案都撞上同一个物理上限,才会被认定为能力缺失。
这套门槛用来区分「代码写得不对」和「硬件本身做不出这个动作」,避免智能体一碰到失败就盲目训练新控制器。
第五次运行的 A02 任务是个清楚的例子。目标位置离地 1.25 米、距离墙面 0.30 米。
任务子智能体先用初始控制器在 15 种开发变体里测试,全部失败。优化到最优版本后,竖直方向误差从 0.22–0.24 米缩小到 0.20–0.21 米,依旧是 0.05 米允许误差的四倍左右。
智能体由此判断,根源是机器人躯干抬升高度不足,提议学习两个控制器:一个用来借助墙面支撑抬高机身,另一个适配该支撑姿态,跟踪机械臂末端位置。
这套判断机制建立在信息隔离的基础上。
协调者无法查看原始调试轨迹和视频,任务子智能体也拿不到私有任务定义、仿真配置、训练参数以及留出测试集。是否需要训练新控制器,只依据开发阶段的反馈报告,留出测试的结果不会参与决策。
新控制器训练完成后,还要经过验收环节。
它需要在无额外辅助的条件下通过评估,再使用同一个模型检查点、相同接入程序、同一套核验流程,在 15 种开发变体上连续跑两轮,两轮全部达标,才会存入能力库。
入库之后,协调者会再分配一个全新的任务子智能体,使用扩充后的能力库重试原来的任务。任务程序切换控制器有明确触发条件,同一时间,只会有一个控制器输出关节动作。
模板之内自己定训练
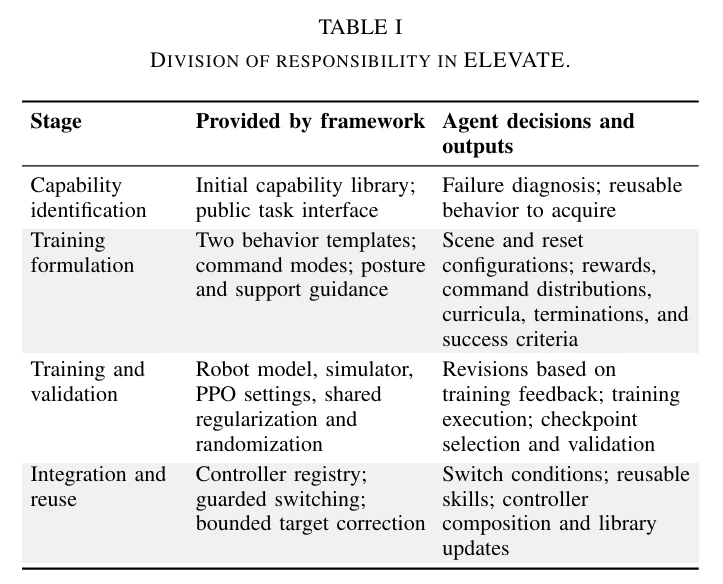
确定要学习的新能力后,就交由控制器子智能体接手。整个框架只提供两类基础模板:一类是身体重构,用来训练机器人形成并维持全新姿态;另一类是支撑操作,训练机器人在稳住身体的同时,控制机械臂跟踪目标末端位置。
机器人模型、仿真环境、PPO(近端策略优化)训练器、通用正则项、域随机化策略以及训练步数上限,都由框架预先配置完毕。
模板划定了边界,但内部所有细节都由智能体自主决定:选择哪个部位作为支撑、目标姿态的形态、奖励函数的设计、训练课程的排布、单局训练的终止条件、判定学会的标准,全部由它自主敲定。
它会先读取机器人几何参数和训练配置,判断目标动作是否具备可行性,先做一小段 PPO 预实验,再启动正式训练、评估候选控制器,结合数值指标和回放录像迭代调整参数。
为了保证新控制器能够衔接原有状态,每一轮训练都从上一个控制器实际运行出的状态起点开始。
学习扶墙支撑姿态的过程,就能直观看到它调整奖励的思路。
最开始的奖励函数优先优化俯仰角和肩部高度,训练出来的策略会向后下蹲,俯仰角达标,但肩部高度反而下降,前腿也没能搭上墙面。
智能体核对奖励权重和回放画面后,新增抬高躯干、前腿抵墙两项奖励,同时上调向上的辅助作用力。
开启辅助时,96% 的诊断轮次都可以完成支撑姿态;随后关闭辅助继续训练,最终 100% 的评估轮次都能稳定维持该姿态直到时限。
这个过程,很像研究生手动调奖励参数,只不过执行者换成了智能体。
研究也统计了完整的成本。A01 到 B03 共五轮完整测试,单轮总耗时 20.0–22.2 小时,其中控制器训练本身累计耗时 4.2–6.3 小时,全程仅使用一张英伟达 RTX 5090 显卡。
单轮的大模型调用费用在 253–343 美元,显卡成本不计入在内。
每一轮测试里,智能体对控制器方案做出实质性调整 1–5 次,平均 3.4 次,改动集中在奖励函数、训练课程、终止条件上。依靠一张消费级显卡、不到一天时间、数百美元的模型调用成本,这套系统就自主学到了三套全新的全身控制器。
仿真考核与真机落地
实验硬件平台为宇树 Go2 四足机器人,搭载 6 自由度的松灵 PiPER 机械臂。机身前部配备摄像头与激光雷达,机械臂末端搭载 Intel D405 深度相机。
任务程序以 10Hz 频率运行,控制器 50Hz,仿真物理环境 200Hz。真机沿用这套硬件配置,控制器权重直接从仿真环境迁移,全程没有使用真机数据做训练或微调。
七项任务按固定顺序开展。
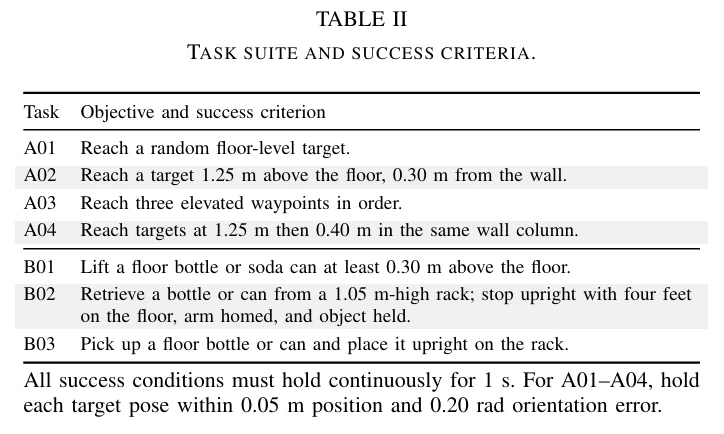
A01 至 A04 是四项伸手类任务:从拾取地面随机目标,到够取高处目标、依次途经三个高处点位、先取高处再拾取低处物体;
B01 至 B03 是三项物体操作任务:从地面捡起瓶罐、从 1.05 米高货架取回瓶子并平稳落地站立、将地面的瓶子放置到货架上。
A01 和 B01 在初始控制器的能力覆盖范围内,剩下五项任务都超出了原生动作的能力边界。伸手任务可以直接获取末端相对于目标的位姿误差,物体类任务只能依靠视觉完成定位。
对照组尽可能控制变量,三组方案统一使用 Claude Opus 5.5,依托 Claude Code 执行,推理参数、初始能力库、任务顺序、观测输入、评测变体以及成功判定标准全部保持一致。
ASPIRE 和 ELEVATE 的唯一差别,就是关闭了自主训练新控制器的能力;Code-as-Policies 则进一步关闭反馈驱动的程序迭代,每个任务仅生成一份固定程序。每项任务设置 15 个开发变体、50 个留出测试变体,每种方案独立跑 5 轮,总计 1750 次留出测试。
结果要分开看。在初始控制器本来就能完成的 A01、B01 任务上,ELEVATE 没有明显优势,ASPIRE 平均成功率还略高。
差距集中在其余五项超出原生能力的任务:两组基线方案在留出测试里全部失败,ELEVATE 的平均成功率稳定在 98.4%–100%。
七项任务综合统计,ELEVATE 成功率 99.0%,ASPIRE 为 28.4%,Code-as-Policies 仅 23.0%。单轮记录更直观:A02、A04 在获取新控制器之前 50 次测试全部失败,拿到新控制器之后,50 次全部成功。
学到的技能可以持续复用。五轮测试里,系统都会在 A02、A04 阶段,把能力库从 1 个扩充到 4 个;后续 A03、B01 至 B03,不再训练新控制器。
第五轮测试中,A02 学会的扶墙支撑姿态与支撑操作,直接被 A03 复用;A04 额外训练了一个脱离墙面的控制器,组合出回到平地的动作;B02 依靠扶墙抬高身体的能力取货,再携带瓶子平稳落地;B03 组合地面抓取和扶墙抬升两套技能,完成上架放瓶。
五轮测试之间互不继承成果,每一轮自主学出来的支撑姿态,参数、命名都不一样,俯仰角目标分布在 0.68–0.85 弧度,但功能逻辑趋同。不同智能体各自探索,最终收敛到同一种解决思路。
研究还在 A02 场景里新增箱子作为障碍,不额外给提示,智能体自主更换支撑点,学会将前腿搭在箱子上完成支撑。
真机测试更换了感知链路:物体掩码由 Meta 的 SAM 3 分割模型生成,Go2 前置摄像头负责搜寻、靠近目标;末端 D405 相机输出掩码,结合深度信息与标定参数,在机器人坐标系中定位操作目标,任务程序据此规划靠近、抓取、切换控制器、放置等动作。
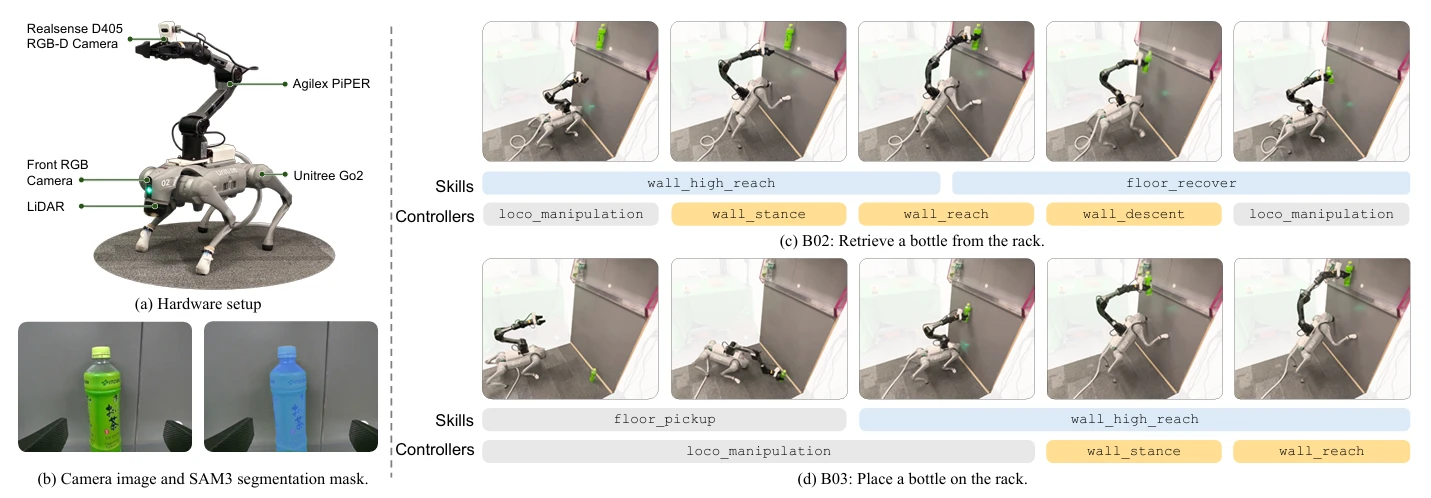
两项真机任务各测试 20 次。B02 货架取瓶、持瓶平稳落地,成功 18 次;B03 地面捡瓶、放到货架上,成功 16 次。失败大多出在抓取环节:B02 两次失败是夹爪和瓶子接触面积不足,机器人从墙面回落时加速度偏大,瓶子滑脱;B03 的失败主要是拾取阶段夹爪误碰撞瓶子。
编码 Agent 的两种选择
几乎同期,英伟达 Xue Bin Peng 团队发表另一篇研究,同样打通编码智能体与全身控制,论文题为《METATRON: A Promptable Whole-Body Execution Layer for Humanoids》,思路和 ELEVATE 恰好相反。第一作者为 Chen Tessler,团队来自英伟达与 Dollhouse Robotics。
METATRON 先用人体动捕数据、合成的倒地恢复轨迹、经过重定向的场景交互动作,联合训练出一个支持提示输入的全身基础策略,训练完成后直接冻结。这里的提示是碎片化目标:某一时刻身体部位的期望位置、速度指令或是风格标签都可以。新技能以普通程序实现,编码智能体分析动作数据、提炼简洁规则,在每一个控制周期,把任务意图转化为提示,交给这个固定策略生成全身动作。

两项研究对编码智能体的定位截然不同。ELEVATE 遇到能力缺口时,会训练全新的底层控制器,让能力库持续扩充;METATRON 的底层策略全程固定不变,智能体只负责在上层编排技能,能力上限由预训练阶段见过的动作决定。简单来说,前者相当于让智能体充当强化学习工程师,后者则是让智能体兼任动画师与程序员。
METATRON 的定量测试全部在仿真环境内完成。在 MuJoCo 的 54 组全身伸手任务中,METATRON 成功率 83%;两组参考轨迹跟踪对照方案仅 39%、28%,不叠加手臂逆运动学的 GRU 方案成功率为 0。当机器人以 1m/s 速度行走,对躯干施加 100 毫秒瞬时推力时,800 牛、1000 牛推力下 METATRON 的恢复成功率为 75%,两组对照方案全部失败。600 牛推力下成功率降至 62%,800 牛和 1000 牛又回升至 75%,这个非单调的结果,不能理解成推力越大稳定性越好。
真机演示环节,METATRON 使用冻结模型权重,在宇树 G1 人形机器人上完成摇杆控制行走、PICO 头显遥操作抓取、坐沙发起身、多种倒地姿态自主站起等效果。真机没有配套定量数据,坐沙发任务还需要人为把机器人预先放置到沙发旁,并输入目标提示。ELEVATE 真机测试样本量不大,但给出了明确的成功次数;METATRON 面向结构更复杂的人形机器人,可实现的行为更加丰富,配套完整代码与模型权重,已经随英伟达 ProtoMotions 开源。
把两项研究放在一起看,能发现编码智能体的能力正在持续下沉:从单纯编写调用接口的程序,逐步深入到机器人的全身运动控制层面。
对于科研人员来说,控制器库不必在一开始就规划完备,能够跟随任务需求动态扩充;研究者的工作重心,转向设计训练模板、控制算力成本、制定验收标准。
对于开发四足、人形机器人的企业,这套方案的吸引力在于成本:单次完整测试的大模型调用成本仅数百美元,训练只需要一张消费级显卡。
这套模式能不能迁移到更多机型、拓展更多动作,能不能跳出模板的限制生成全新姿态,目前还没有定论。机器人依靠任务失败自主习得新能力,已经在搭载机械臂的四足机器人身上迈出第一步。