

视觉语言动作模型
共 10 篇相关内容
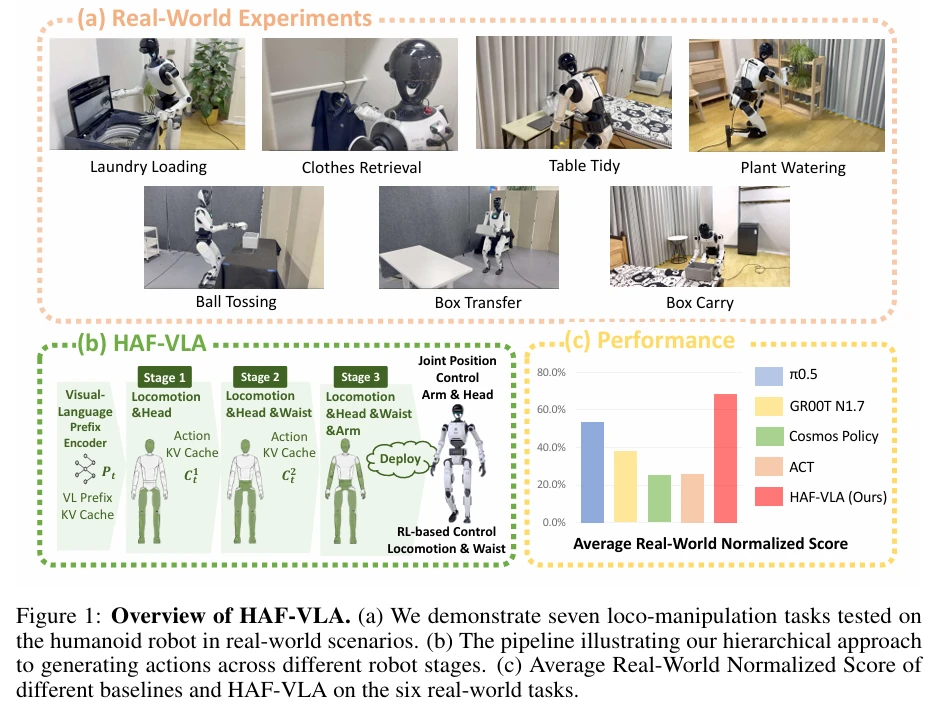
仉尚航等提出 HAF-VLA,让人形机器人分层生成协调的全身动作
仉尚航等提出 HAF VLA,让人形机器人分层生成协调的全身动作 人形机器人要学会自主走向目标、俯身、再伸手抓取,卡点在于全身动作的协同生成。腿、腰、头部与双臂串联在同一条运动学链上:底盘偏移几厘米、腰部角度差几度,手臂就得伸得更远代偿。持…
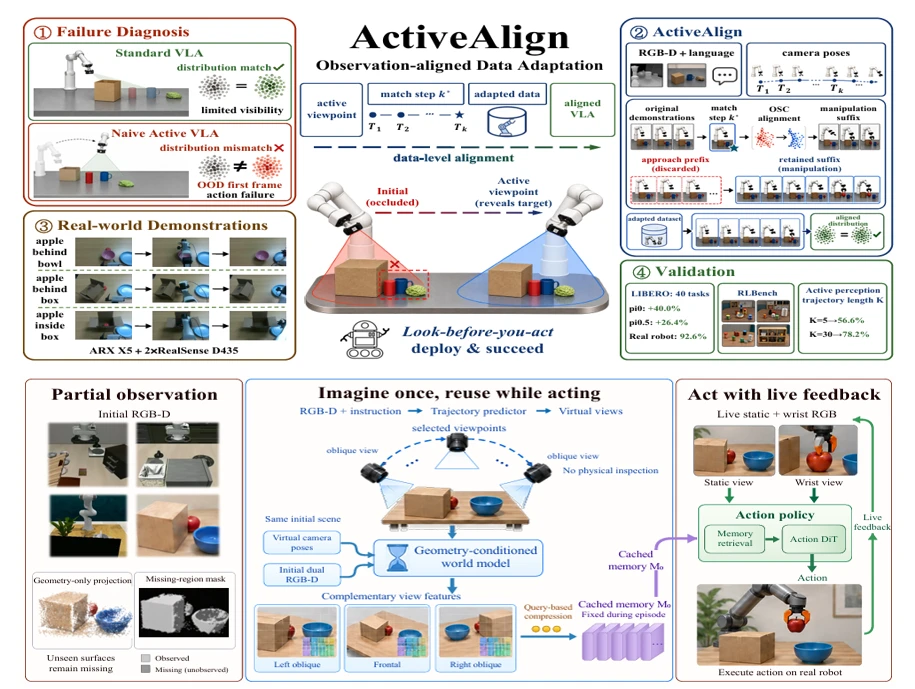
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作
同一天两篇论文,复旦大学付彦伟团队:机器人先行感知,接住新视角下的动作 机器人伸手抓取被杂物遮挡的杯子,最直观的解法就是转动腕载相机重新观测。但相机转动会同步改变机械臂构型,策略将面临训练期间从未见过的初始状态,图像、位姿与剩余任务之间的关…

对话 Shallow-π 作者:压缩 Transformer 层级,具身模型竟做得更好?
一个圆柱、一块正在转动的孔板,足以让两种机器人模型拉开差距。 在 Shallow π 的真实机器人实验中,任务要求机械臂拿起圆柱,插入移动中的小孔。层数更多的大模型,可能在等待计算结果的过程中错过位置;一个层数更少、输出接近它的小模型,却能…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…
依托世界模型倒带复盘,智元 Rollback 让单台真机 8 小时追上人类均值
机器人一旦做错决策,能不能退回节点换个动作重新尝试? 这在现实物理世界很难,就像积木塔一旦倒塌,不会自己复原。机器人每试错一次,都要人工重置场景、把道具摆回初始状态,才能开启下一轮试验。 大量时间和成本都耗在场景复位上,这正是实体机器人强化…
具身智能前沿取得重大突破!SuperMimic 或为机器本体扫清算力障碍
10 月 21 日,加州大学伯克利分校(UC Berkeley)团队公开论文《SuperMimic: Scaling Humanoid Whole Body Control with One Differentiable World Mod…

对话 StageCraft 作者,聊一聊 VLA 从本体迁移到环境变化差在哪
今年 IEEE/RSJ 智能机器人与系统国际会议(IROS)于 9 月 27 日至 10 月 1 日期间在美国匹兹堡召开。 本届 IROS 收录的论文接近 1,900 篇,分设三百多个主题报告场次。 作为机器人领域与 ICRA 齐名的两大顶…

上海交通大学与蓝箭航天团队联合发布 DynaForge,让失败的演示变成能用的训练数据
DynaForge 让动态操作的演示不必再靠人手一条条去采集。机器人可在仿真环境自主试跑,从失败回合中学习修正量,把原本失败的轨迹转化为可供策略训练的有效演示。 9 月 22 日,上海交通大学自动化与感知学院联合蓝箭航天空间科技股份有限公司…
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
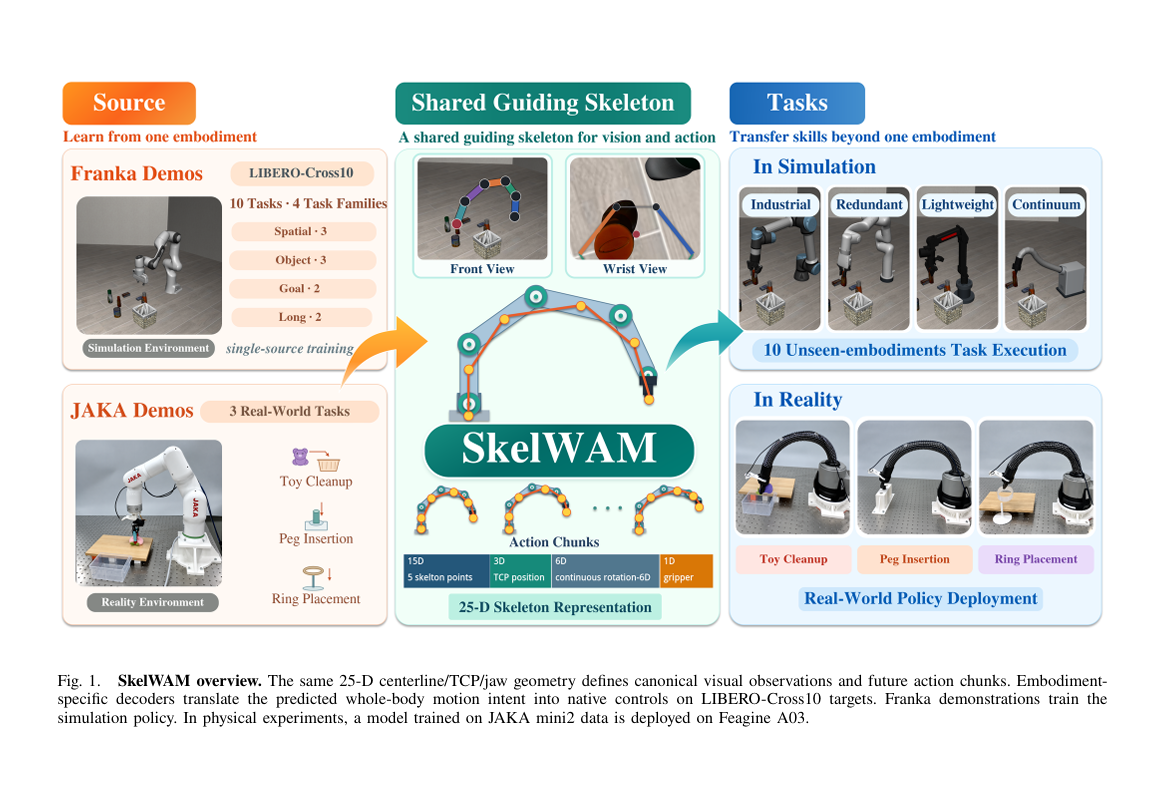
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移…
日均 1 起融资,具身智能的疯狂 7 月,背后藏着这些信号
在 7 月过去的上半月,国内具身智能领域的融资共有 16 起,也就是日均 1 起,频率之高,令人咋舌。 而且,融资总金额超过 30 亿元。对比 2024 年全年,具身领域总共 90 起融资,融资总金额 89.33 亿元。那么钱都去了哪里?4…