

论文
共 67 篇相关内容
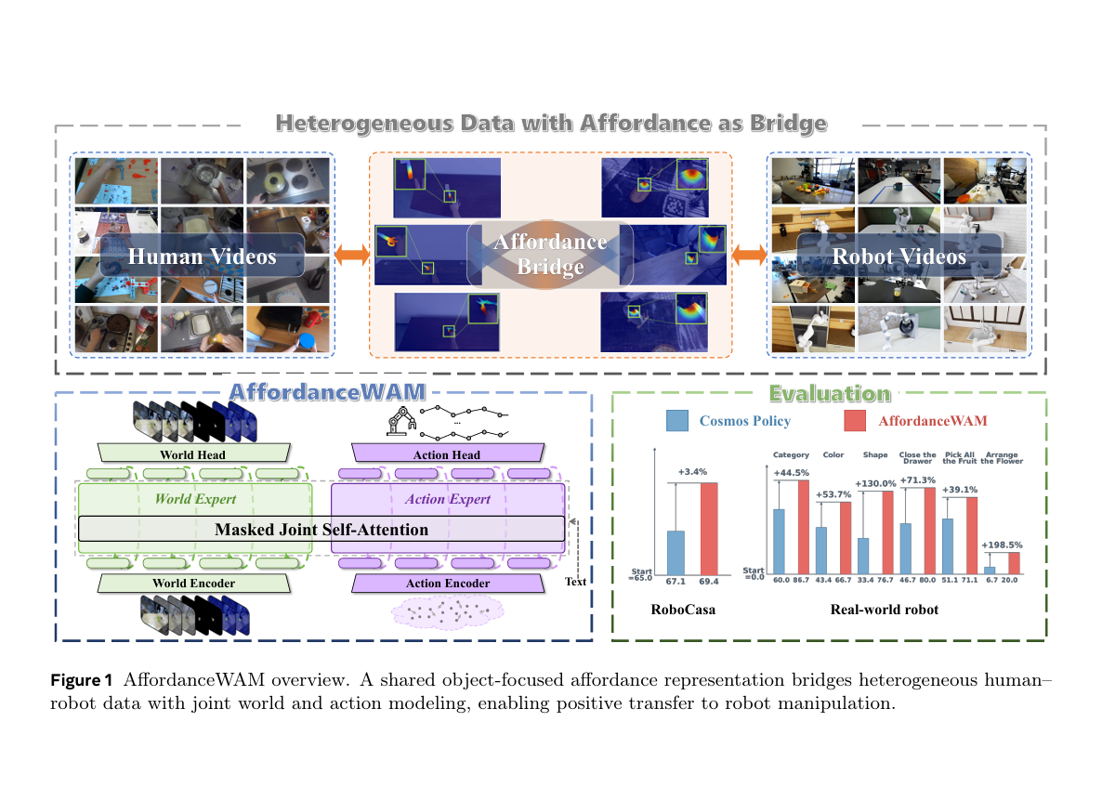
港大、港科广、北大等五校团队联合发布 AffordanceWAM,靠可供性激活真人训练视频
AffordanceWAM 的核心突破,是将「物体可交互位置与方式」的可供性,纳入世界动作模型的显式预测目标,彻底解决真人第一视角视频难以适配机器人训练的行业痛点,让原本容易造成负迁移的真人数据,转变为可规模化扩展的有效监督信号。 9 月 …
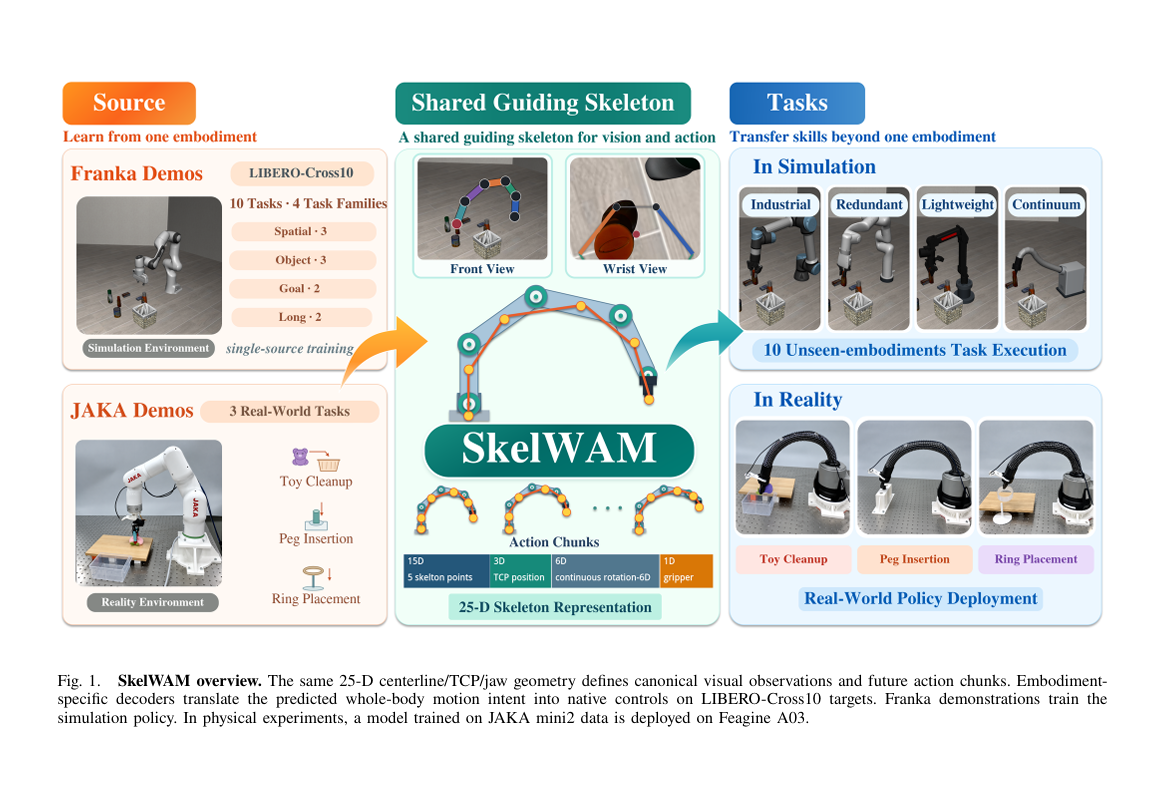
清华赵行团队与北大刘珂团队发布 SkelWAM,用骨架让策略零样本跨十种机械臂
SkelWAM 实现了在一台机器人上训练好的操作策略,可以直接部署到其他不同结构的机器人身上。研究团队设计了一套统一手臂骨架的公共几何表征。模型接收视觉画面,读取本体状态,预测后续动作,全部基于这套表征。策略只在 Franka 上训练,迁移…
对话清华大学教授曹婷,物理自进化的「因果」与突破
9 月 21 日, 「 ICCL 自进化 · 物理智能 Open Day」 在清华大学无锡研究院智能产业创新中心举行 。 中国工程院外籍院士、清华大学智能产业研究院创始院长张亚勤罕见亮相并致辞,首创「物理自进化(PSI, Physical …
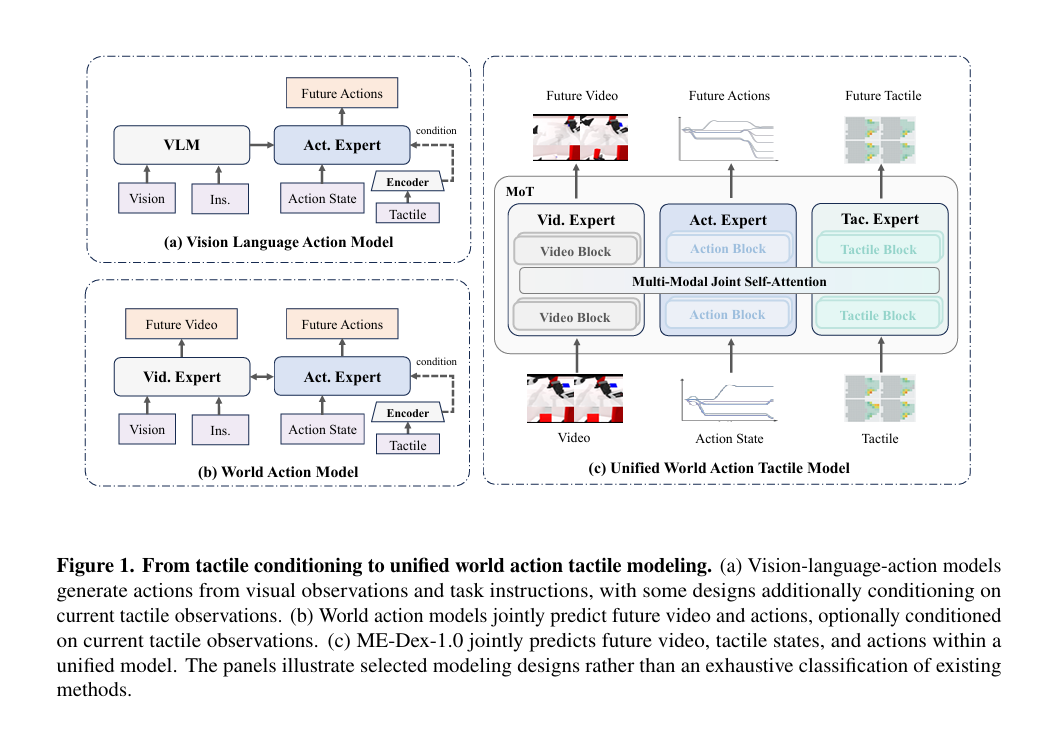
理想汽车基座模型团队提出 ME-Dex 1.0,让触觉和画面一起预测未来
ME Dex 1.0 让机器人在输出动作前,预先计算下一步会产生的接触状态。理想汽车基座模型团队将视觉、触觉、动作三路专家模块整合进同一个去噪框架;触觉与图像一样,被视作需要预测的未来观测。团队还借助手部模板,把不同灵巧手、夹爪的触觉信息对…
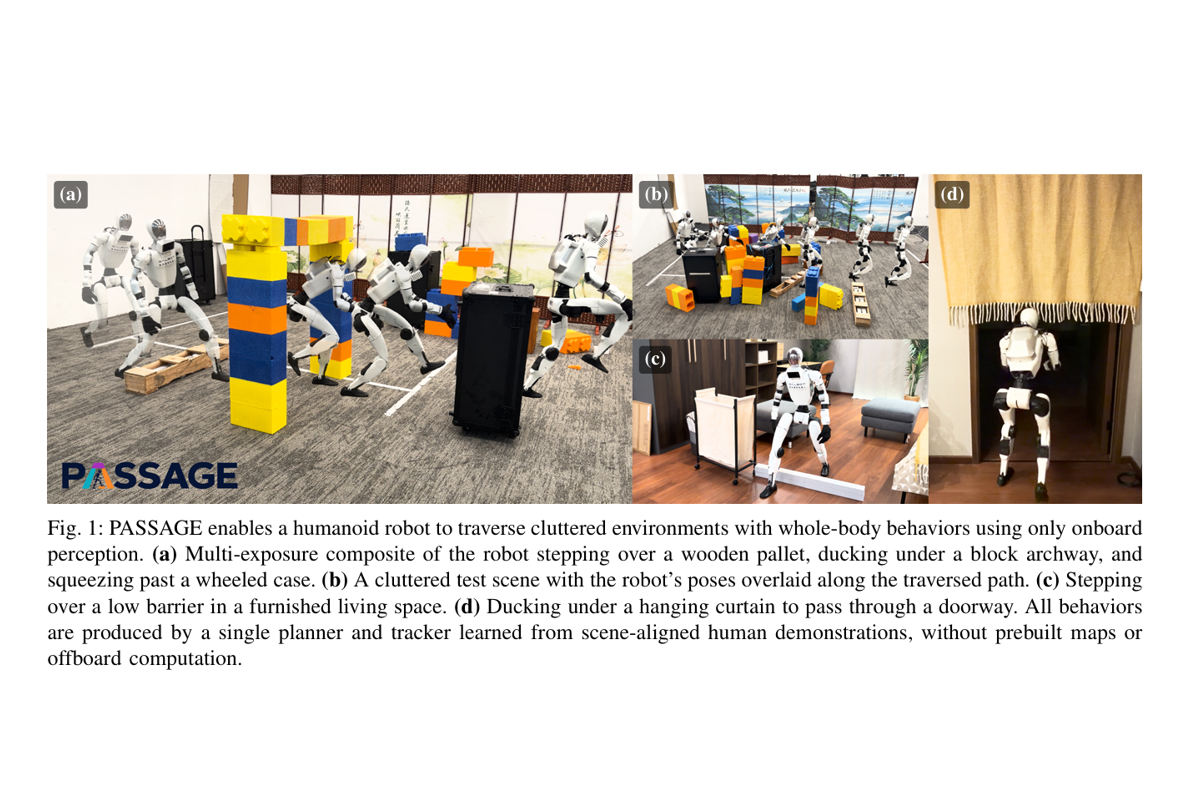
清华大学弋力团队发布 PASSAGE,让人形机器人自己挑动作穿过杂物间
PASSAGE 研究将场景对齐的人体动作数据积累至100小时量级,通过流匹配规划器搭配感知增强的全身追踪器架构,让人形机器人能够在杂乱受限环境中自主选择并组合跨越下穿侧身避让等多元运动动作。仿真测试结果可以直观证明,机器人无接触通行的成功率…
对话上海交大杨理欣:为什么机器人需要一条「三维时间轴」
机器人会倒水,却可能在放下瓶子后忘了刚才倒过哪一瓶。会执行动作,不等于知道任务该如何推进;机器人还需要把任务意图、行动历史与世界变化连成一条三维时间线。 这类失败不完全是抓取精度问题。今天的视觉—语言—动作模型(Vision Languag…
星海图赵行:机器人的下一次 Scaling,不只发生在预训练
机器人抓起一个商品,只能说明它会做一个动作。展台上的机器人完成一次抓取,与它进入前置仓持续接单、拣选和打包,是两种不同的考验。 前者可以被压缩成一条成功轨迹,后者却要求机器人理解订单、定位货架、自主导航、处理随机摆放的商品,还要在多机协同时…
对话眺月科技王方正:造一台既会跳、也会飞的机器人
还没来得及正式打招呼,眺月科技 CEO 王方正已经准备开始演示产品。 「我们先来看看这个产品吧,让它跳起来给大家演示一下。」 那是上海创新创意设计研究院的一间大会议室。长桌上摆着电脑和咖啡杯,并不是专门为机器人清理出来的测试场地。王方正把机…
ACE-Data-0 开源背后:我们和大晓机器人聊了聊具身数据的下一步
机器人看视频就能学会一切?那你就太高估它了。 比如生活中最简单的场景,从桌面拿起水杯。这件事人类几乎不需要思考;对机器人而言,却是一条由感知、移动、抓握、接触、物体状态变化和任务记忆共同组成的长链条。 视频可以告诉模型「拿起水杯」,但手指在…

独家对话周顺波:就算没有 AGI,也能做一台大家喜欢的机器人
在创立欧拉万象以前,周顺波已经做了近 12 年机器人。 2015 年,他进入香港中文大学徐扬生院士的实验室,才真正开始做机器人。他参与研发过一只熊猫形态的疗愈机器人,后来被送进香港沙田医院,陪伴自闭症儿童和阿尔茨海默病老人。那时,这类机器人…
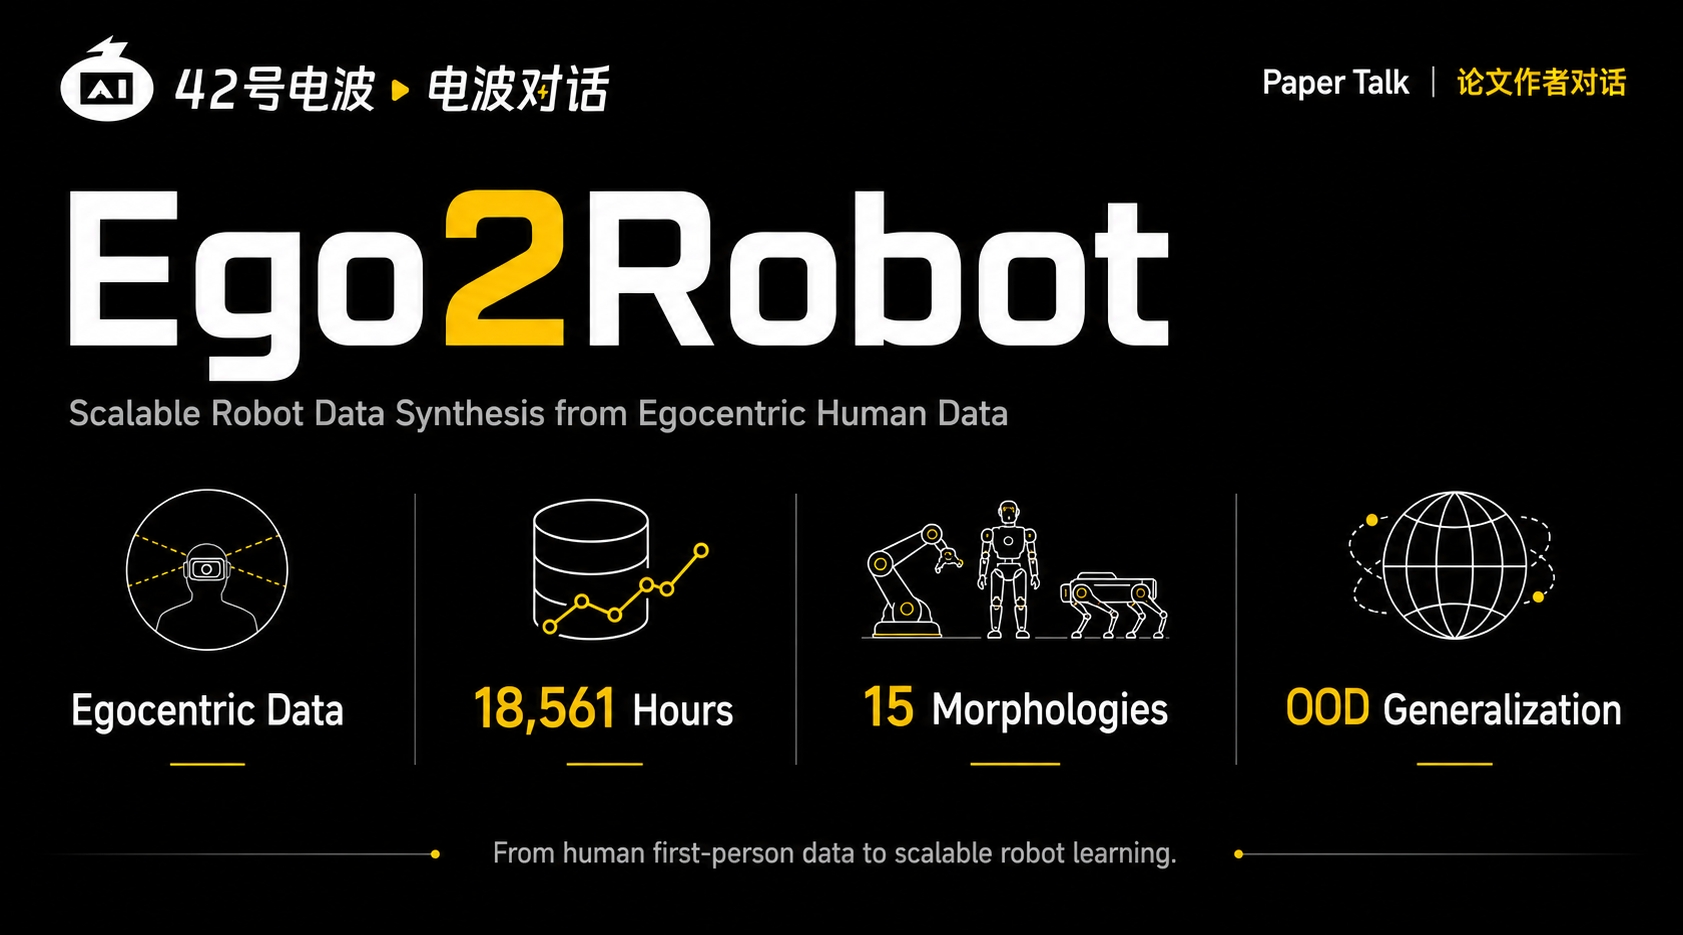
模型之外,Ego2Robot 让数据处理管线当回主角
一台机器人在固定桌面上完成任务,和换了桌布、改了光照、挪了相机位置之后仍然做对,是两种完全不同的能力。前者说明策略已经收敛,后者才决定它能不能走出实验室。 众所周知,机器人遥操作天然比人类中心视频慢、贵。而此前工作仅在小规模单任务上验证过「…
上交卢策吾、浙大等团队提出 Track4Action:把「动作后的 3D 世界」蒸馏进 VLA
VLA 模型可以把图像和语言指令转换成机器人动作,训练的过程中,研究人员通常只评价机器人的动作像不像专家。至于机器人的动作会怎样改变物体、空间关系和任务状态,通常没有被明确交给模型学习。短任务可能掩盖这个缺口;一旦任务变长,或者视角、背景和…